Análise de vídeo
13 modelos de análise de vídeo: comparação e recomendações por tarefa
Compare 13 modelos de análise de vídeo e escolha conforme a tarefa: compreensão audiovisual com Gemini, análise de quadros com GPT e Claude ou busca e localização de eventos com modelos especializados.
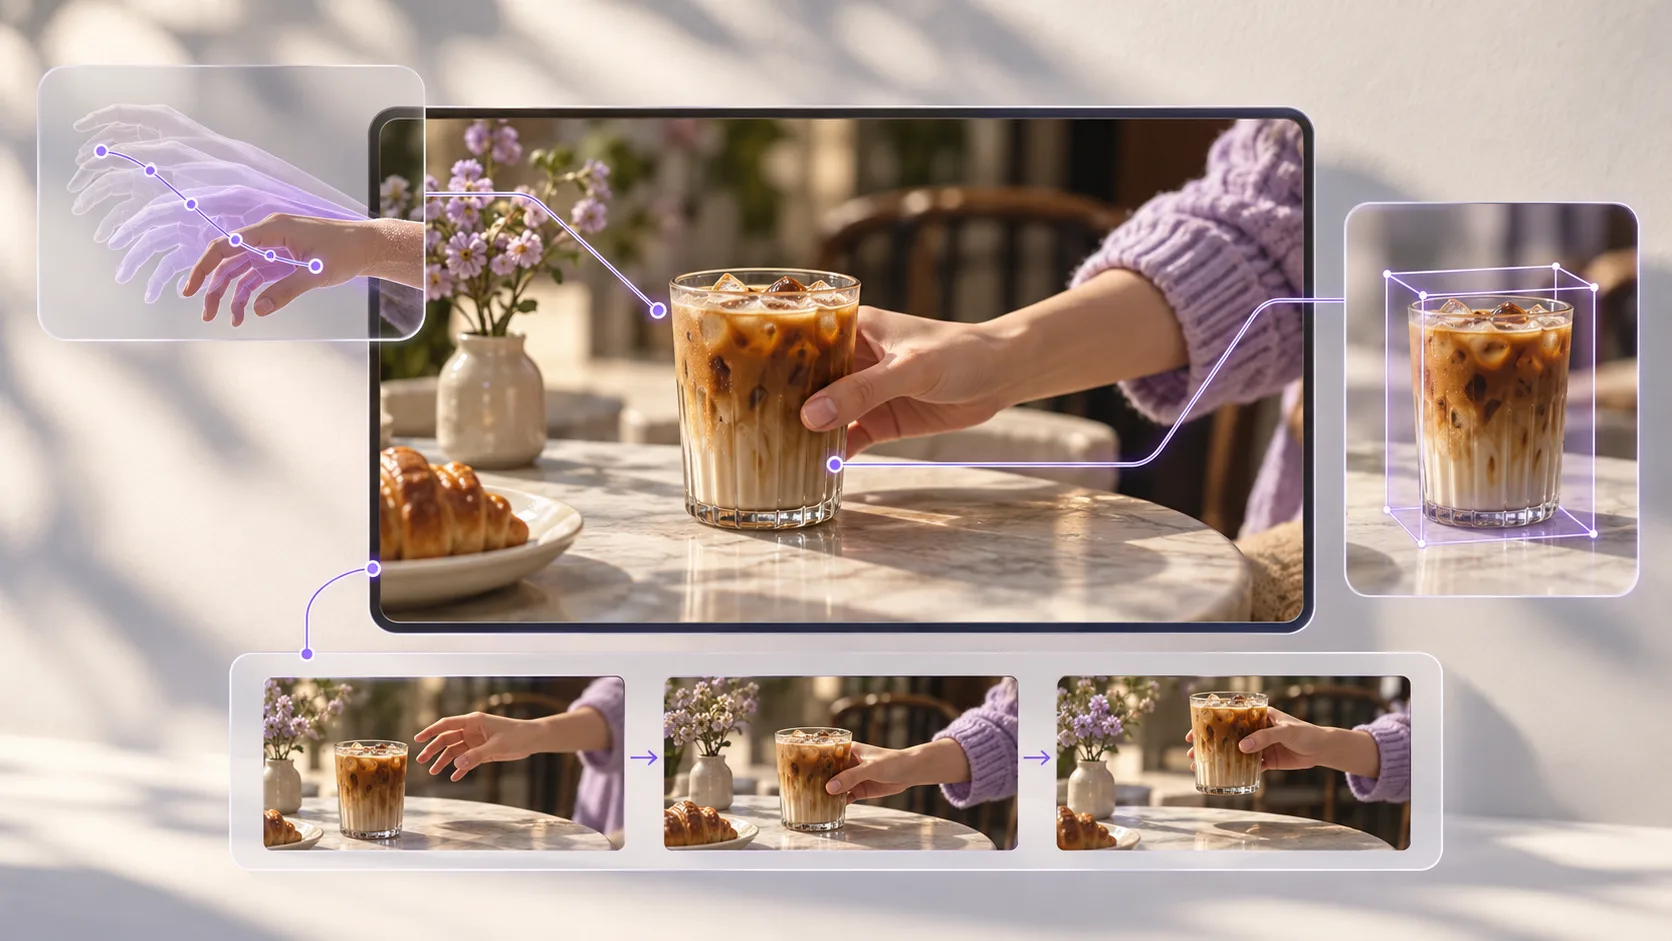
Um bom modelo de análise de vídeo explica quem fez o quê e em que momento, com imagens que permitem conferir a resposta. Compare 13 modelos e veja seis opções para compreensão geral, raciocínio visual, processamento em lote, organização de acervos e localização de eventos.
Comece pela tabela comparativa
A comparação reúne avaliações públicas e documentação dos fornecedores. As tabelas mostram quais tarefas foram avaliadas, quais entradas cada modelo aceita e como interpretar as pontuações. As seis recomendações ajudam a escolher o modelo conforme a tarefa de produção.
Tarefas abordadas: Análise de vídeos de referência, perguntas e respostas sobre vídeo, localização de eventos e busca em acervos. Dados consultados em: 18 de outubro de 2026. Modelos e entradas: Cada versão e configuração de entrada é tratada separadamente. Aplicativos de chat, APIs de imagem e APIs de vídeo podem oferecer recursos diferentes, mesmo quando são do mesmo fornecedor.
1.1 O que avaliar: compreensão, precisão e localização dos eventos
| Dimensão | O que verificar | Indicadores sugeridos |
|---|---|---|
| Fatos visuais e texto | O modelo reconhece corretamente pessoas, objetos, cenários e textos na tela? | Precisão factual; taxa de erro no reconhecimento de texto na imagem |
| Ações e tempo | O modelo distingue pegar de colocar um objeto, entrar de sair e a ordem das ações? | Proporção de eventos encontrados (recall); precisão da ordem das ações |
| Localização temporal e espacial | A descrição corresponde ao trecho real, e o alvo pode ser localizado em uma região da imagem? | Interseção sobre união temporal (tIoU); erro nos limites temporais; interseção sobre união das caixas delimitadoras |
| Consistência em vídeos longos | Personagens, objetos e relações narrativas permanecem consistentes entre os planos? | Precisão das respostas por duração do vídeo; taxa de confusão de identidade entre trechos |
| Compreensão audiovisual conjunta | É possível distinguir ações visíveis, diálogos reais, música de fundo e sons fora da tela? | Comparação com e sem áudio; precisão em perguntas com conflito entre áudio e imagem |
| Evidências e incerteza | O modelo acrescenta acontecimentos que não aparecem no vídeo? Indica dúvidas quando a imagem não é clara? | Proporção de afirmações sem evidência; proporção de marcações de tempo que correspondem ao vídeo original |
| Custo real de uso | Quantas chamadas, quanto tempo de espera e quantas correções manuais são necessários para produzir uma análise aceitável? | Custo total por relatório aprovado; latência P50/P95; minutos de revisão manual |
Avalie cada métrica separadamente: precisão das respostas, proporção de trechos relevantes encontrados e erro nos limites temporais. Uma média pode esconder problemas que afetam diretamente a edição, como deixar de identificar uma ação curta ou marcar seu início no momento errado.
1.2 Como as entradas influenciam a avaliação
Amostrar um vídeo a um quadro por segundo oferece uma cobertura diferente de selecionar um número fixo de imagens. Áudio e legendas também alteram as informações disponíveis para o modelo. O Video-MME v2 usa pontuação não linear por grupos para avaliar a consistência das respostas a perguntas relacionadas. Ao comparar resultados, confira a quantidade de quadros e o uso de áudio em cada configuração, inclusive nos modelos Omni. [1] Video-MME v2
A avaliação de compreensão de vídeo do StarZero reúne modelos gerais e especializados recentes. Ela usa um conjunto de dados privado, o que limita a reprodução independente dos resultados. As pontuações abaixo vêm dessa avaliação; os recursos e usos de cada modelo seguem a documentação dos fornecedores. [2] StarZero
13 modelos comparados: opções gerais e especialistas em vídeo
As primeiras 10 linhas mostram pontuações do StarZero em ordem decrescente. As últimas 3 apresentam opções para outras tarefas ou sem pontuação comparável. A escala vai até 100, e “±” indica o intervalo de confiança de 95%. Intervalos sobrepostos exigem cautela ao interpretar pequenas diferenças. A última coluna destaca as entradas aceitas e as condições de uso.
| Modelo | Tipo de modelo | Pontuação StarZero | O que considerar ao escolher |
|---|---|---|---|
| Gemini 4 Argon | Multimodal de uso geral | 81.1 ± 1.9 | Suporte oficial a vídeo e áudio; candidato para análise abrangente |
| Claude Opus 5.5 | Raciocínio visual de uso geral | 77.7 ± 4.0 | Entrada de imagens; tarefas de vídeo exigem sequências de quadros e informações de tempo |
| Muse Wonder | Modelo avaliado pelo StarZero | 77.5 ± 3.1 | Pontuação disponível; consulte o fornecedor para conhecer as condições de acesso |
| GPT-6 Astra | Raciocínio visual de uso geral | 76.7 ± 6.2 | A API aceita imagens; não aceita entrada direta de vídeo ou áudio |
| Gemini 3.8 Flash | Multimodal de uso geral | 76.1 ± 6.9 | Compreensão de vídeo e áudio; candidato para análise em lote |
| Qwen3.8 Max | Modelo avaliado pelo StarZero | 74.6 ± 2.6 | Versão Max da família Qwen3.8; avalie esta versão com seus próprios vídeos |
| GPT-6.1 Sol | Modelo avaliado pelo StarZero | 72.4 ± 2.0 | Versão distinta do Astra, com pontuação própria |
| Gemini 3.7 Flash | Multimodal de uso geral | 69.1 ± 4.2 | Referência para comparar versões da família Flash |
| Qwen3.8 Flash | Modelo avaliado pelo StarZero | 61.1 ± 9.8 | Versão Flash da família Qwen3.8, com configuração e pontuação próprias |
| TwelveLabs Pegasus 1.6 | Modelo especializado em vídeo para texto | 35.3 ± 3.6 | Extração de eventos, etiquetas e metadados com marcações de tempo |
| DeepSeek-V4-Flash-Vision-Exp [3] | Compreensão experimental de imagens | — | Versão experimental com entrada de imagens, para análise baseada em quadros |
| Vidi2.5 | Modelo de pesquisa em localização espaço-temporal | — | Localiza ações em intervalos de tempo e caixas delimitadoras |
| TwelveLabs Marengo 3.5 | Modelo especializado em embeddings multimodais | — | Para sistemas próprios de busca; gera vetores, não relatórios de análise diretamente |
Fonte dos valores: Avaliação original do StarZero, consultada em 18 de outubro de 2026. As pontuações mantêm a escala da fonte e abrangem as configurações selecionadas para esta tabela.
Como comparar os modelos especializados O Marengo 3.5 gera vetores multimodais para sistemas próprios de busca. A API Search da TwelveLabs ainda usa o Marengo 3.0. Já o Vidi2.5 se concentra na localização de ações no tempo e no espaço. Avalie o Marengo pela qualidade dos trechos recuperados e o Vidi2.5 pela precisão da localização. [4] Marengo 3.5; [5] Relatório técnico do Vidi2.5
Seis recomendações para diferentes tarefas
Escolha conforme o material e o resultado esperado: compreensão de cenas e áudio, interpretação de quadros, coordenação de ferramentas, análise em lote, organização de acervos ou localização precisa de ações.
01 · Gemini 4 Argon: compreensão de vídeos complexos
O Gemini 4 Argon é uma opção para analisar imagens, áudio e contexto longo em conjunto. Sua ficha oficial lista entradas de texto, imagem, áudio e vídeo. Em narrativas longas, confira se o modelo acompanha os personagens até o final e sustenta suas explicações sobre as ações com evidências do vídeo. [6] Ficha oficial do modelo
02 · Claude Opus 5.5: interpretação de quadros-chave
O Claude Opus 5.5 pode relacionar quadros-chave, marcações de tempo e transcrições para produzir explicações estruturadas. Como aceita texto e imagens, prepare esses materiais antes da análise. Extraia quadros adicionais para ações rápidas e inclua uma transcrição quando o som for necessário para entender a cena. [7] Documentação da Anthropic sobre modalidades de entrada
03 · GPT-6 Astra: análise com várias ferramentas
O GPT-6 Astra pode coordenar ferramentas para extrair quadros, ler transcrições, buscar materiais e preparar relatórios. Sua API aceita imagens, mas não recebe vídeo ou áudio diretamente. Forneça quadros com marcações de tempo e processe o áudio com ferramentas específicas. [8] Documentação do modelo OpenAI
04 · Gemini 3.8 Flash: referências e análise em lote
Para coleções de vídeos curtos, o Gemini 3.8 Flash é uma opção para a primeira análise. Compare o custo por relatório aprovado com seus próprios materiais. A documentação do Google descreve um modo que explora a linha do tempo conforme necessário; o processamento estático usa 1 fps por padrão e pode perder ações rápidas. Confira quais controles o serviço utilizado disponibiliza. [9] Documentação do Google sobre compreensão de vídeo
05 · TwelveLabs Pegasus 1.6: acervos e anotação de eventos
O Pegasus 1.6 transforma vídeos em eventos, etiquetas e metadados com marcações de tempo. A documentação descreve análise de vídeos em primeira pessoa, extração de eventos por trecho e saída estruturada, recursos úteis para organizar acervos e anotar ações. Se o material contiver falas em chinês, confira os diálogos e os termos específicos da sua área: o suporte a esse idioma é parcial. [10] Documentação do Pegasus 1.6
06 · Vidi2.5: localização de ações para edição
O Vidi2.5 busca responder em qual trecho uma ação acontece e quem a realiza. Seu relatório técnico cobre busca temporal, localização espaço-temporal e perguntas sobre vídeo, com resultados em intervalos de tempo e caixas delimitadoras. É uma opção de pesquisa e desenvolvimento; antes de integrá-lo à produção, confira os requisitos de implantação, a licença e as interfaces disponíveis. [5] Relatório técnico do Vidi2.5
Como comparar os modelos com seus próprios vídeos
Monte um teste inicial com vídeos que você costuma usar: apresentações à câmera, cortes rápidos, demonstrações de produto, gravações de tela com texto pequeno e planos-sequência longos. Inclua pelo menos dois de cada tipo. Marque os eventos, a ordem das ações e os tempos de início e fim. Se possível, peça a duas pessoas que revisem as marcações de forma independente e resolvam as diferenças.
Faça duas rodadas. Na primeira, fixe quantidade de quadros, resolução, transcrição e prompt para comparar modelos com as mesmas evidências. Na segunda, permita os recursos nativos de vídeo de cada modelo e meça o resultado do sistema completo. Apresente as rodadas separadamente e registre versões, configurações de inferência, falhas, novas tentativas e custos, para não confundir vantagens do pré-processamento com vantagens do modelo.
Formato sugerido para registrar o relatório
Vídeo de origem e intervalo de tempo → fatos visíveis → ações em ordem → quadros ou trechos de áudio como evidência → detalhes incertos → conclusão da revisão humana.
Compare os intervalos previstos com as marcações manuais usando a interseção sobre união temporal e conte os eventos omitidos separadamente. Confira a ordem das ações e se cada afirmação tem apoio nas imagens ou no áudio. Para legendas precisas, use transcrição e alinhamento por palavra e revise os tempos no vídeo original.
Qual modelo de análise de vídeo o rikoko usa?
O rikoko usa Gemini para analisar vídeos de referência. O recurso “Gemini Video Analysis” estava disponível na consulta de 18 de outubro de 2026. A configuração de referência usa Gemini 3.8 Flash. A versão ativa depende do serviço conectado. O agente usa a análise das imagens e do áudio para planejar os planos e revisar os resultados.
Escolha o nível de análise conforme a tarefa. A visão geral identifica tema e estilo; a análise por planos organiza a sequência do vídeo; os detalhes para recriação examinam o estado inicial, as fases da ação, as relações espaciais e o estado final. Vídeos longos podem ser divididos em trechos, com os relatórios reunidos ao final.
A análise orienta a produção: entenda a referência, escolha os planos e prepare os materiais que serão gerados. Para gerar vídeo, o rikoko prioriza uma interface MiniMax compatível com as referências necessárias.
Configuração de referência consultada em 18 de outubro de 2026: config/models.fal-testing.example.json. Use-a como exemplo de configuração; consulte o serviço conectado para saber qual versão está ativa. Dividir o vídeo em trechos ajuda a organizar a análise, mas a frequência de amostragem continua dependendo do provedor.
Continue lendo
Três formas de criar vídeos com IA: Agents, Skills e MCP
Entenda como Agents, Skills e MCP participam da produção de vídeo e acompanhe um exemplo de adaptação de anúncio com o rikoko para uma campanha de café cold brew.
Roteiros e storyboards para vídeos com IA: narrativa, planos e prompts
Um guia em cinco etapas, do briefing criativo aos prompts de geração, com roteiro de um vídeo de produto de 30 segundos, seis planos completos e critérios de revisão.
6 modelos de imagem comparados: Nano Banana 2.1 foi o mais rápido e GPT Image 2.5 o mais realista no teste de pôsteres
Compare preços oficiais para imagens em 1080p e resoluções máximas, com imagens originais, tempos de geração e observações visuais de cinco modelos em dois grupos de testes.
Fontes e dados de outubro de 2026. Consulte as referências de cada artigo para comparar versões, preços e resultados.