Análisis de video
13 modelos de análisis de video: comparación y recomendaciones por tarea
Compara 13 modelos de análisis de video según la tarea: comprensión audiovisual con Gemini, análisis de fotogramas con GPT y Claude o búsqueda y localización de eventos con modelos especializados.
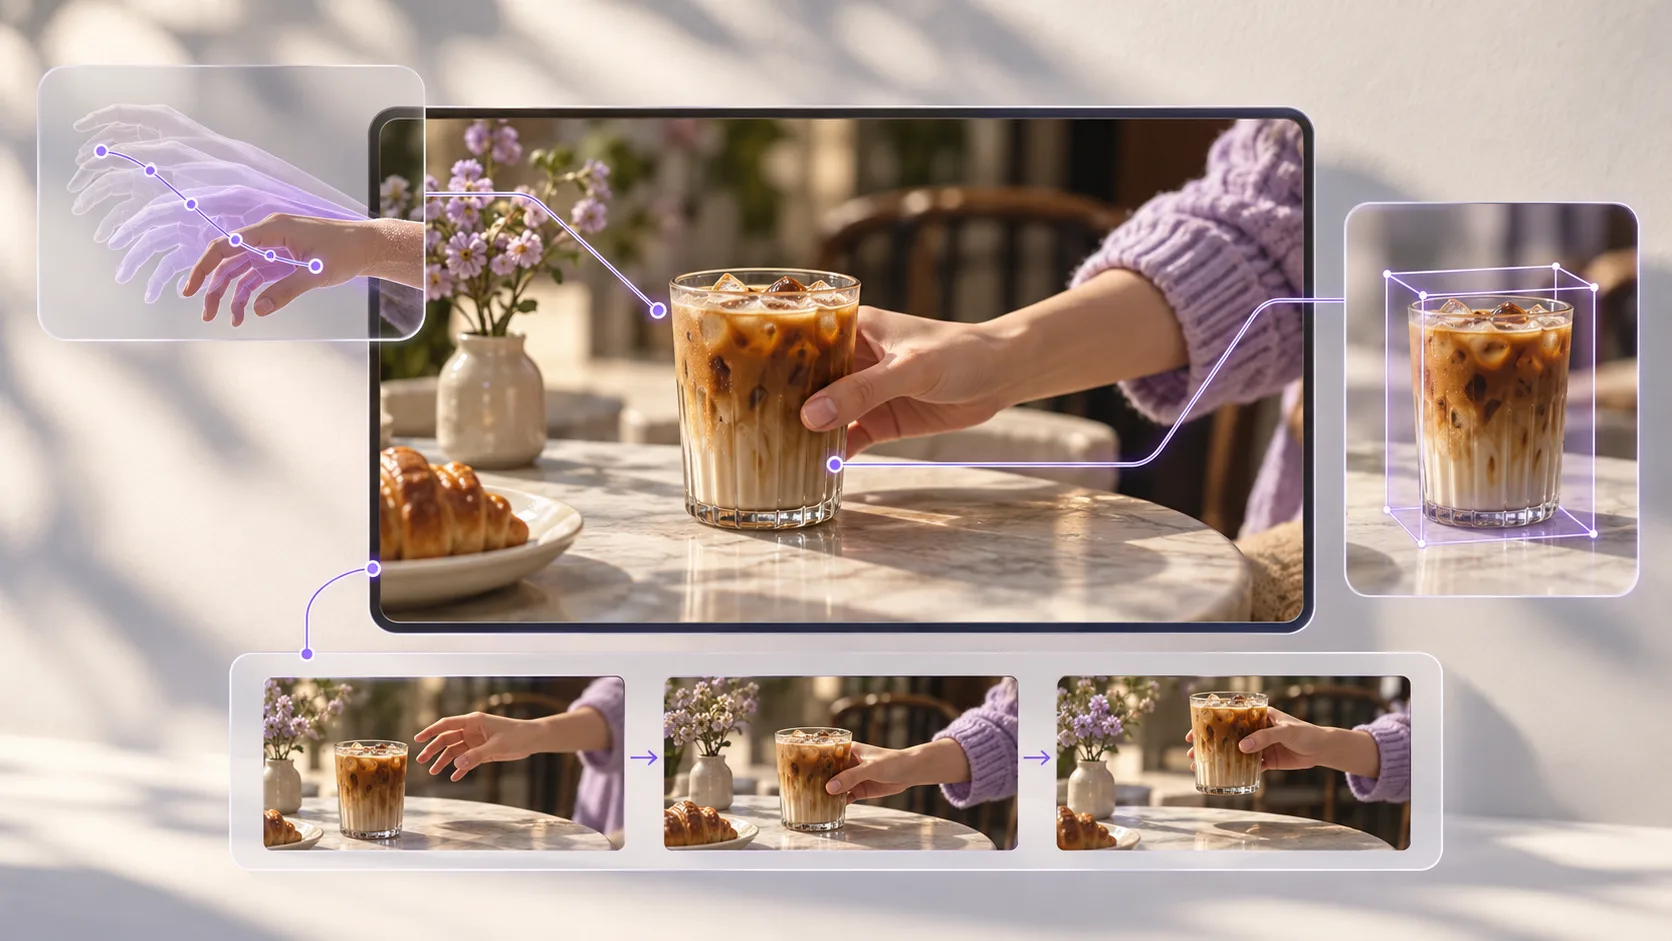
Un buen modelo de análisis de video explica quién hizo qué y en qué momento, con imágenes que permiten comprobar la respuesta. Compara 13 modelos y conoce seis opciones para comprensión general, razonamiento visual, procesamiento por lotes, organización de archivos y localización de eventos.
Empieza por la tabla comparativa
La comparación reúne evaluaciones públicas y documentación de los proveedores. Las tablas muestran qué tareas se evaluaron, qué entradas admite cada modelo y cómo interpretar las puntuaciones. Las seis recomendaciones te ayudan a elegir el modelo según la tarea de producción.
Tareas incluidas: Análisis de videos de referencia, preguntas y respuestas sobre video, localización de eventos y búsqueda en archivos. Datos consultados el: 18 de octubre de 2026. Modelos y entradas: Cada versión y configuración de entrada se trata por separado. Las aplicaciones de chat, las API de imágenes y las API de video pueden ofrecer funciones distintas, incluso cuando pertenecen al mismo proveedor.
1.1 Qué evaluar: comprensión, precisión y localización de eventos
| Dimensión | Qué comprobar | Métricas sugeridas |
|---|---|---|
| Hechos visuales y texto | ¿El modelo reconoce correctamente las personas, los objetos, los escenarios y el texto en pantalla? | Precisión factual; tasa de error en el reconocimiento de texto en pantalla |
| Acciones y secuencia temporal | ¿El modelo distingue levantar de dejar un objeto, entrar de salir y el orden de las acciones? | Proporción de eventos encontrados (recall); precisión del orden de las acciones |
| Localización temporal y espacial | ¿La descripción corresponde al fragmento real y se puede localizar el objetivo dentro de una región de la imagen? | Intersección sobre unión temporal (tIoU); error en los límites temporales; intersección sobre unión de los cuadros delimitadores |
| Consistencia en videos largos | ¿Se mantienen coherentes los personajes, los objetos y las relaciones narrativas entre planos? | Precisión de respuestas por duración del video; tasa de confusión de identidad entre fragmentos |
| Comprensión audiovisual conjunta | ¿Se pueden distinguir las acciones visibles, los diálogos reales, la música de fondo y los sonidos fuera de pantalla? | Comparación con y sin audio; precisión en preguntas con conflicto entre audio e imagen |
| Evidencia e incertidumbre | ¿El modelo añade sucesos que no aparecen en el video? ¿Indica sus dudas cuando la imagen no es clara? | Proporción de afirmaciones sin evidencia; proporción de marcas de tiempo que corresponden al video original |
| Costo real de uso | ¿Cuántas llamadas, cuánto tiempo de espera y cuántas correcciones manuales exige producir un análisis aceptable? | Costo total por informe aprobado; latencia P50/P95; minutos de revisión manual |
Evalúa cada métrica por separado: precisión de las respuestas, proporción de fragmentos relevantes encontrados y error en los límites temporales. Un promedio puede ocultar problemas que afectan directamente la edición, como omitir una acción breve o situar su inicio en el momento equivocado.
1.2 Cómo influyen las entradas en la evaluación
Muestrear un video a un fotograma por segundo ofrece una cobertura distinta de seleccionar una cantidad fija de imágenes. El audio y los subtítulos también cambian la información disponible para el modelo. Video-MME v2 usa una puntuación no lineal por grupos para evaluar la coherencia de las respuestas a preguntas relacionadas. Al comparar resultados, revisa la cantidad de fotogramas y el uso de audio de cada configuración, incluidos los modelos Omni. [1] Video-MME v2
La evaluación de comprensión de video de StarZero reúne modelos generales y especializados recientes. Utiliza un conjunto de datos privado, lo que limita la reproducción independiente de los resultados. Las puntuaciones de la tabla proceden de esa evaluación; las funciones y los usos de cada modelo siguen la documentación de los proveedores. [2] StarZero
13 modelos comparados: opciones generales y especialistas en video
Las primeras 10 filas muestran puntuaciones de StarZero en orden descendente. Las últimas 3 presentan opciones para otras tareas o sin puntuación comparable. La escala llega a 100 y “±” indica el intervalo de confianza del 95%. Cuando los intervalos se superponen, conviene interpretar con cautela las diferencias pequeñas. La última columna destaca las entradas admitidas y las condiciones de uso.
| Modelo | Tipo de modelo | Puntuación de StarZero | Qué considerar al elegir |
|---|---|---|---|
| Gemini 4 Argon | Multimodal de propósito general | 81.1 ± 1.9 | Soporte oficial de video y audio; candidato para análisis integral |
| Claude Opus 5.5 | Razonamiento visual de propósito general | 77.7 ± 4.0 | Entrada de imágenes; las tareas de video requieren secuencias de fotogramas e información temporal |
| Muse Wonder | Modelo evaluado por StarZero | 77.5 ± 3.1 | Puntuación disponible; consulta las condiciones de acceso con el proveedor |
| GPT-6 Astra | Razonamiento visual de propósito general | 76.7 ± 6.2 | La API admite imágenes; no admite entrada directa de video ni audio |
| Gemini 3.8 Flash | Multimodal de propósito general | 76.1 ± 6.9 | Comprensión de video y audio; candidato para análisis por lotes |
| Qwen3.8 Max | Modelo evaluado por StarZero | 74.6 ± 2.6 | Versión Max de la familia Qwen3.8; evalúa esta versión con tus propios videos |
| GPT-6.1 Sol | Modelo evaluado por StarZero | 72.4 ± 2.0 | Versión distinta de Astra, con puntuación propia |
| Gemini 3.7 Flash | Multimodal de propósito general | 69.1 ± 4.2 | Referencia para comparar versiones de la familia Flash |
| Qwen3.8 Flash | Modelo evaluado por StarZero | 61.1 ± 9.8 | Versión Flash de la familia Qwen3.8, con configuración y puntuación propias |
| TwelveLabs Pegasus 1.6 | Modelo especializado en video a texto | 35.3 ± 3.6 | Extracción de eventos, etiquetas y metadatos con marcas de tiempo |
| DeepSeek-V4-Flash-Vision-Exp [3] | Comprensión experimental de imágenes | — | Versión experimental con entrada de imágenes, para análisis basado en fotogramas |
| Vidi2.5 | Modelo de investigación en localización espaciotemporal | — | Localiza acciones en intervalos de tiempo y cuadros delimitadores |
| TwelveLabs Marengo 3.5 | Modelo especializado en embeddings multimodales | — | Para sistemas propios de búsqueda; genera vectores, no redacta directamente informes de análisis |
Fuente de los valores: Evaluación original de StarZero, consultada el 18 de octubre de 2026. Las puntuaciones mantienen la escala de la fuente y abarcan las configuraciones seleccionadas para esta tabla.
Cómo comparar los modelos especializados Marengo 3.5 genera vectores multimodales para sistemas propios de búsqueda. La API Search de TwelveLabs todavía utiliza Marengo 3.0. Vidi2.5 se centra en localizar acciones en el tiempo y el espacio. Evalúa Marengo por la calidad de los fragmentos recuperados y Vidi2.5 por la precisión de la localización. [4] Marengo 3.5; [5] Informe técnico de Vidi2.5
Seis recomendaciones para distintas tareas
Elige según el material y el resultado que necesitas: comprensión de escenas y audio, interpretación de fotogramas, coordinación de herramientas, análisis por lotes, organización de archivos o localización precisa de acciones.
01 · Gemini 4 Argon: comprensión de videos complejos
Gemini 4 Argon es una opción para analizar imágenes, audio y contexto largo en conjunto. Su ficha oficial incluye entradas de texto, imagen, audio y video. En narraciones largas, comprueba si sigue a los personajes hasta el final y respalda sus explicaciones sobre las acciones con evidencia del video. [6] Ficha oficial del modelo
02 · Claude Opus 5.5: interpretación de fotogramas clave
Claude Opus 5.5 puede relacionar fotogramas clave, marcas de tiempo y transcripciones para producir explicaciones estructuradas. Como admite texto e imágenes, prepara estos materiales antes del análisis. Extrae fotogramas adicionales para las acciones rápidas e incluye una transcripción cuando el sonido sea necesario para entender la escena. [7] Documentación de Anthropic sobre modalidades de entrada
03 · GPT-6 Astra: análisis con varias herramientas
GPT-6 Astra puede coordinar herramientas para extraer fotogramas, leer transcripciones, buscar materiales y preparar informes. Su API admite imágenes, pero no recibe video ni audio directamente. Proporciona fotogramas con marcas de tiempo y procesa el audio con herramientas específicas. [8] Documentación del modelo OpenAI
04 · Gemini 3.8 Flash: referencias y análisis por lotes
Para colecciones de videos cortos, Gemini 3.8 Flash es una opción para el primer análisis. Compara el costo por informe aprobado con tus propios materiales. La documentación de Google describe un modo que explora la línea de tiempo según sea necesario; el procesamiento estático usa 1 fps por defecto y puede omitir acciones rápidas. Consulta qué controles ofrece el servicio que utilizas. [9] Documentación de Google sobre comprensión de video
05 · TwelveLabs Pegasus 1.6: archivos y anotación de eventos
Pegasus 1.6 transforma videos en eventos, etiquetas y metadatos con marcas de tiempo. Su documentación describe análisis de videos en primera persona, extracción de eventos por fragmento y salida estructurada, funciones útiles para organizar archivos y anotar acciones. Si el material contiene diálogos en chino, revisa las frases y los términos de tu área: la compatibilidad con ese idioma es parcial. [10] Documentación de Pegasus 1.6
06 · Vidi2.5: localización de acciones para edición
Vidi2.5 busca responder en qué fragmento sucede una acción y quién la realiza. Su informe técnico cubre búsqueda temporal, localización espaciotemporal y preguntas sobre video, con resultados en intervalos de tiempo y cuadros delimitadores. Es una opción de investigación y desarrollo; antes de integrarlo en producción, consulta los requisitos de implementación, la licencia y las interfaces disponibles. [5] Informe técnico de Vidi2.5
Cómo comparar los modelos con tus propios videos
Prepara una prueba inicial con los videos que sueles utilizar: presentaciones a cámara, cortes rápidos, demostraciones de producto, grabaciones de pantalla con texto pequeño y planos secuencia largos. Incluye al menos dos de cada tipo. Anota los eventos, el orden de las acciones y los tiempos de inicio y fin. Si es posible, pide a dos personas que revisen las marcas de forma independiente y resuelvan las diferencias.
Realiza dos rondas. En la primera, fija la cantidad de fotogramas, resolución, transcripción y prompt para comparar modelos con la misma evidencia. En la segunda, permite las capacidades nativas de video de cada modelo y mide el resultado del sistema completo. Presenta las rondas por separado y registra versiones, ajustes de inferencia, solicitudes fallidas, reintentos y costos para no confundir ventajas del preprocesamiento con ventajas del modelo.
Formato sugerido para registrar el informe
Video de origen e intervalo de tiempo → hechos visibles → acciones en orden → fotogramas o fragmentos de audio como evidencia → detalles inciertos → conclusión de la revisión humana.
Compara los intervalos previstos con las marcas manuales mediante la intersección sobre unión temporal y cuenta los eventos omitidos por separado. Revisa el orden de las acciones y si cada afirmación se apoya en las imágenes o el audio. Para subtítulos precisos, usa transcripción y alineación por palabra y comprueba los tiempos en el video original.
¿Qué modelo de análisis de video utiliza rikoko?
rikoko utiliza Gemini para analizar videos de referencia. La función “Gemini Video Analysis” estaba disponible en la consulta del 18 de octubre de 2026. La configuración de referencia utiliza Gemini 3.8 Flash. La versión activa depende del servicio conectado. El agente utiliza el análisis de las imágenes y el audio para planificar los planos y revisar los resultados.
Elige el nivel de análisis según la tarea. La visión general identifica el tema y el estilo; el desglose por planos organiza la secuencia del video; los detalles para recreación examinan el estado inicial, las fases de la acción, las relaciones espaciales y el estado final. Los videos largos pueden dividirse en fragmentos y sus informes reunirse al final.
El análisis orienta la producción: comprende la referencia, elige los planos y prepara los materiales que se van a generar. Para generar video, rikoko prioriza una interfaz MiniMax compatible con las referencias necesarias.
Configuración de referencia consultada el 18 de octubre de 2026: config/models.fal-testing.example.json. Úsala como ejemplo de configuración; consulta el servicio conectado para conocer la versión activa. Dividir el video en fragmentos ayuda a organizar el análisis, pero la frecuencia de muestreo sigue dependiendo del proveedor.
Sigue leyendo
Tres formas de crear videos con IA: Agents, Skills y MCP
Descubre cómo participan Agents, Skills y MCP en la producción de video, con un ejemplo de adaptación de un anuncio con rikoko para una campaña de café cold brew.
Guiones y storyboards para videos con IA: narrativa, planos y prompts
Una guía en cinco etapas, del brief creativo a los prompts de generación, con el guion de un video de producto de 30 segundos, seis planos completos y criterios de revisión.
6 modelos de imagen comparados: Nano Banana 2.1 fue el más rápido y GPT Image 2.5 el más realista en la prueba de carteles
Compara precios oficiales para imágenes en 1080p y resoluciones máximas, con imágenes originales, tiempos de generación y observaciones visuales de cinco modelos en dos grupos de pruebas.
Fuentes y datos de octubre de 2026. Consulta las referencias de cada artículo para comparar versiones, precios y resultados.